En el mundo de la Ciencia de Datos, tener habilidades técnicas es solo la mitad de la batalla. La otra mitad, y a menudo la más crucial, es saber cómo abordar un problema de negocio de manera estructurada y eficiente. Sin un mapa de ruta claro, los proyectos de datos pueden volverse caóticos, costosos y, lo peor de todo, irrelevantes para la empresa.
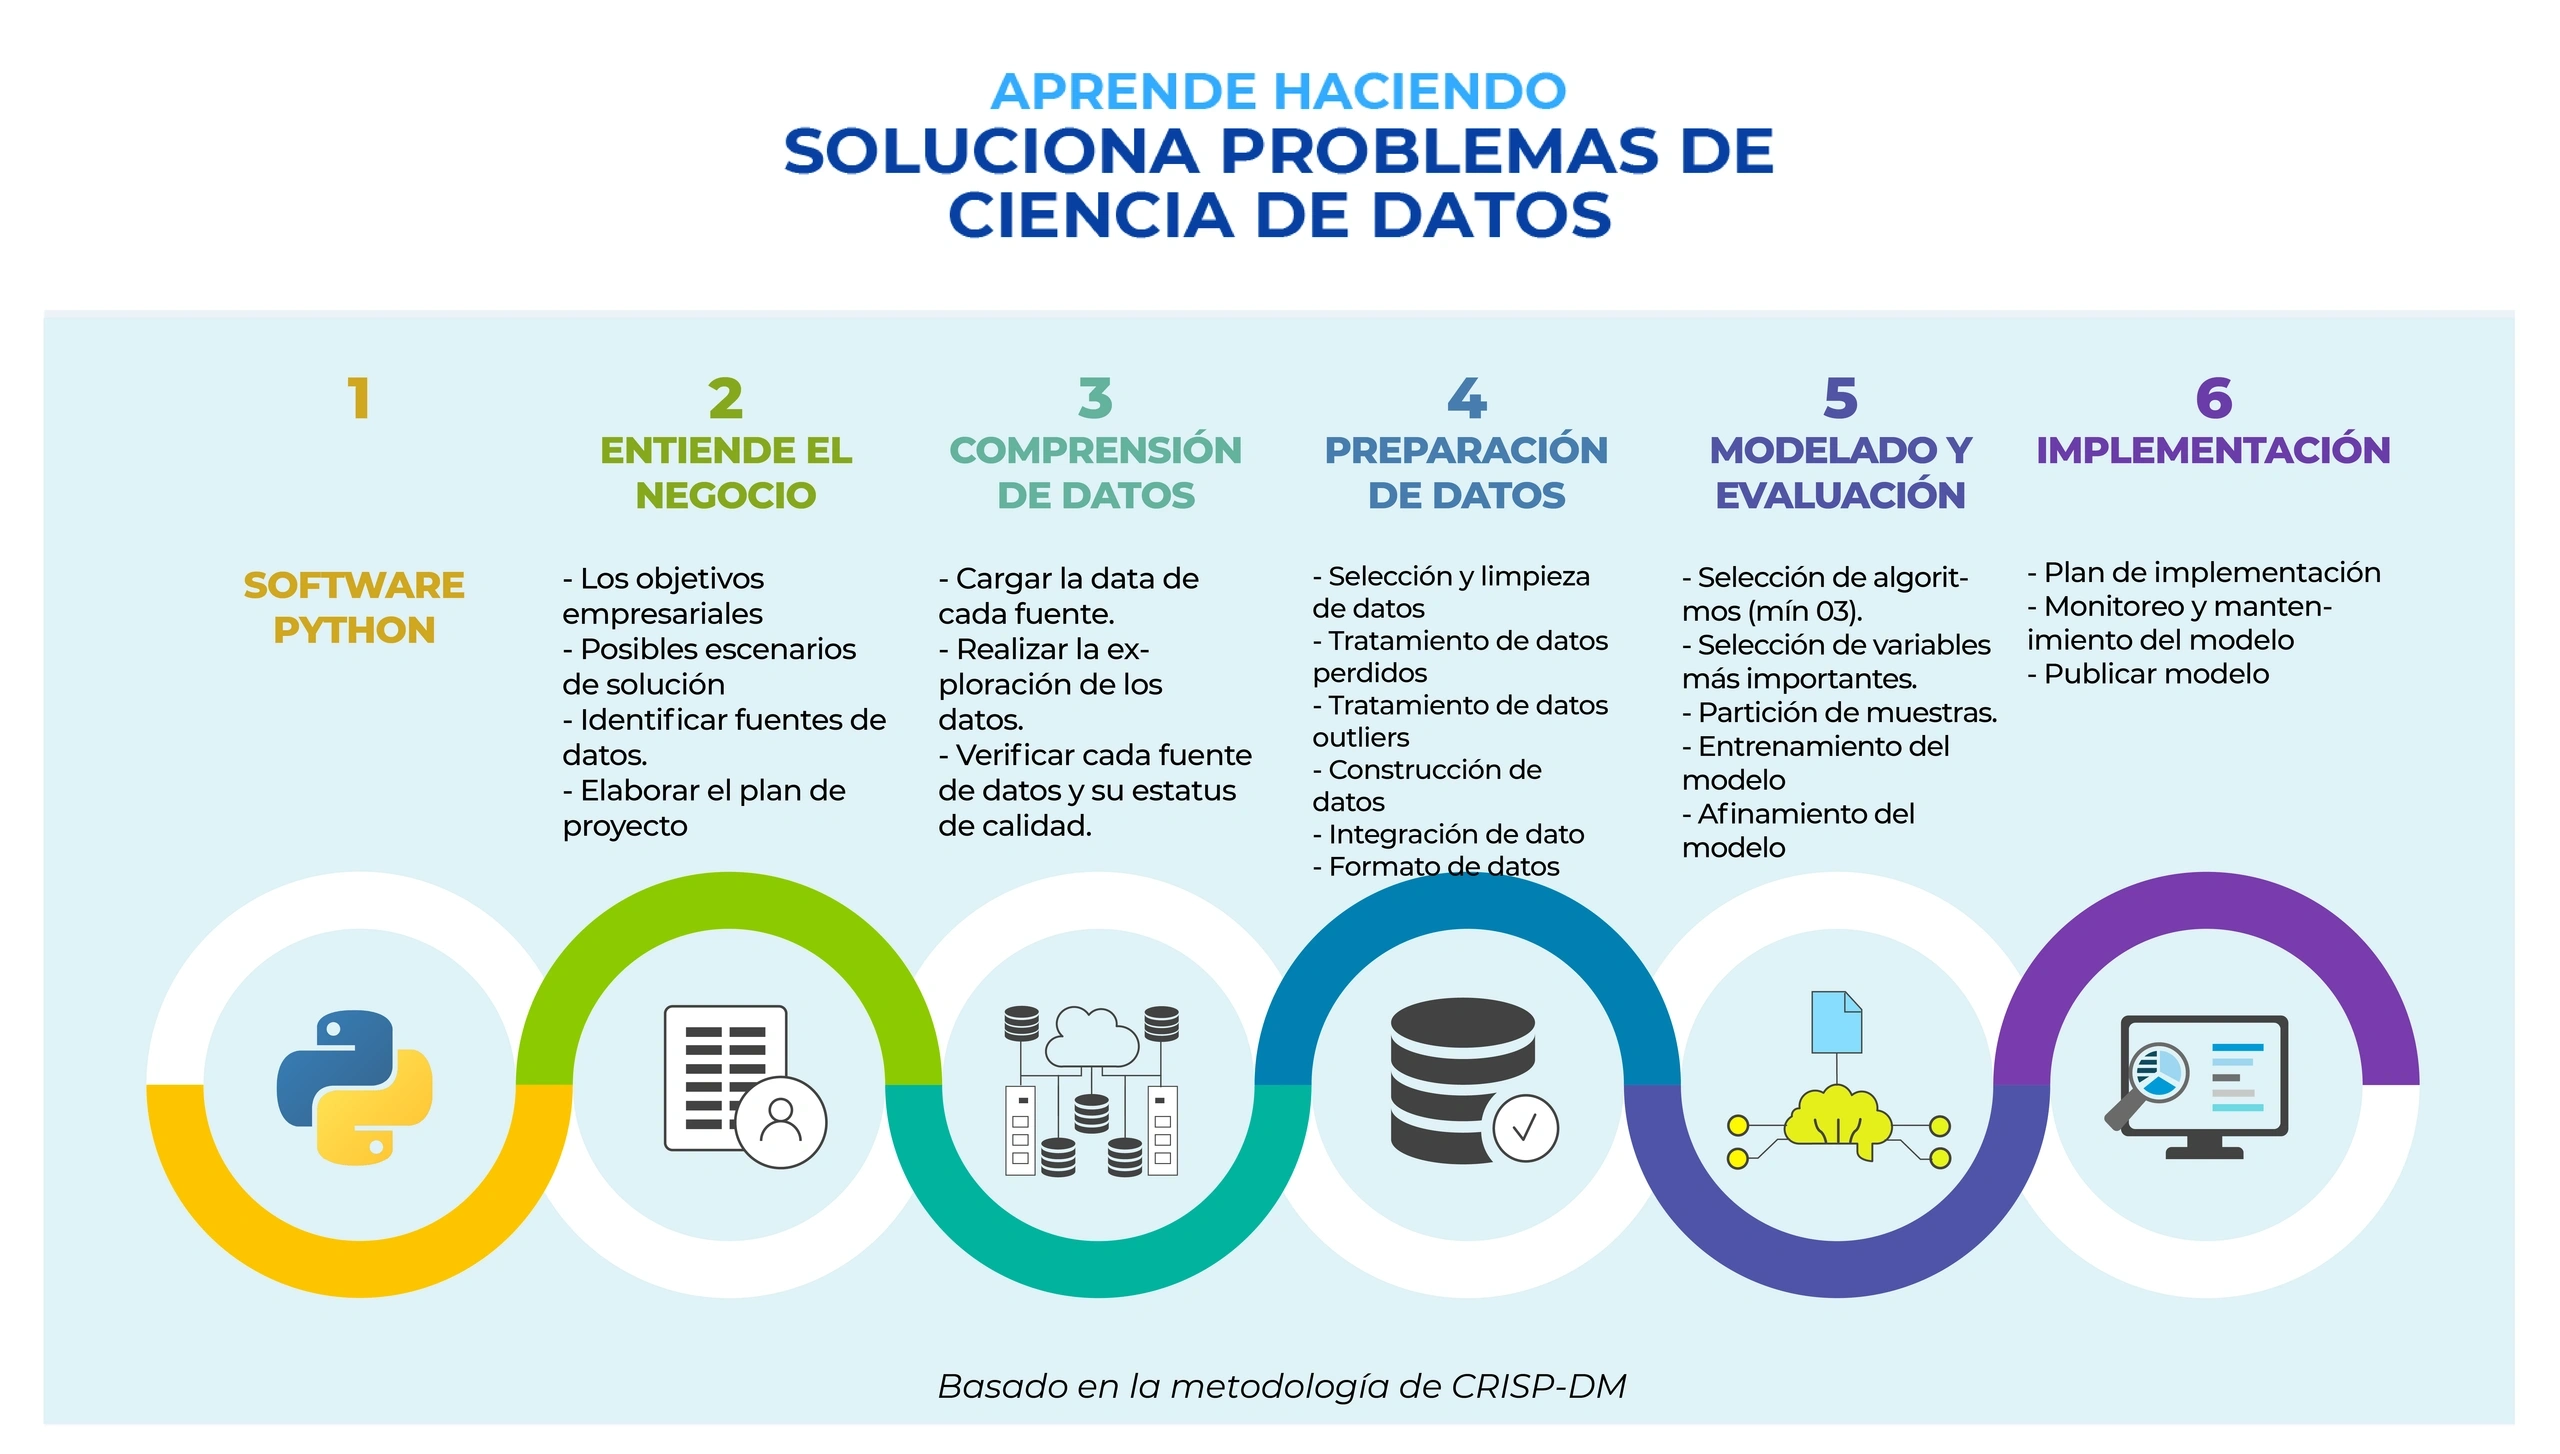
Aquí es donde entra CRISP-DM (Cross-Industry Standard Process for Data Mining), la metodología estándar de la industria que guía un proyecto desde la concepción de la idea hasta el despliegue del modelo.
En este artículo, te guiaremos a través de los pasos exactos para solucionar problemas de Ciencia de Datos utilizando CRISP-DM, sirviéndonos de Python como nuestra herramienta principal.
El Cimiento Técnica: Software Python
Antes de sumergirnos en la metodología, debemos establecer nuestra herramienta de trabajo. Python se ha consolidado como el lenguaje líder en Ciencia de Datos debido a su legibilidad y a su ecosistema masivo de librerías especializadas.
Para seguir esta guía, te recomendamos aprender Python y tener familiaridad con librerías clave como:
Pandas & NumPy: Para manipulación y cálculo numérico.
Matplotlib & Seaborn: Para visualización de datos.
Scikit-learn: Para el modelado de Machine Learning.
Fase 1: Entiende el Negocio (Business Understanding)
Esta es la fase más importante y la que más se pasa por alto. Si no entiendes el problema, no puedes resolverlo. Aquí definimos el "por qué" y el "qué".
1. Los objetivos empresariales
¿Qué intenta lograr la empresa? ¿Qué problema intenta resolver la empresa? No busques métricas técnicas aquí, busca métricas de negocio. Ejemplos: "Reducir la fuga de clientes en un 10%", "Incrementar las ventas cruzadas", "Predecir fallos en maquinaria para evitar paradas", "Reducir el riesgo al momento de brindar una tarjeta de crédito" o "Incrementar los desembolsos".
2. Posibles escenarios de solución
Esboza cómo se vería la solución. ¿Es un sistema de recomendación en tiempo real? ¿Es un reporte semanal de riesgos? Define cómo la salida del modelo se integrará en las operaciones diarias. Incluyendo escenarios de uso.
3. Identificar fuentes de datos
¿Dónde está la información necesaria? Debes mapear si los datos están en bases de datos SQL, archivos CSV, APIs externas, logs de servidor o incluso hojas de Excel dispersas.
4. Elaborar el plan de proyecto
Crea un cronograma. Define qué recursos necesitas (tiempo, hardware, personas) y cuáles son los criterios de éxito técnicos y de negocio para dar por concluido el proyecto.
Fase 2: Comprensión de Datos (Data Understanding)
Es hora de ensuciarse las manos con los datos "crudos". El objetivo es familiarizarse con lo que tenemos disponible. Data de fuente primaria y/o secundaria.
1. Cargar la data de cada fuente
Usando Python (principalmente pd.read_csv(), pd.read_sql(), etc.), importamos los datos identificados en la fase anterior a nuestro entorno de análisis.
2. Realizar la exploración de los datos (EDA)
El Análisis Exploratorio de Datos (EDA) es vital. Usamos estadísticas descriptivas (.describe()) y visualizaciones (histogramas, diagramas de caja, scatter plots) para entender las distribuciones, correlaciones y patrones iniciales.
3. Verificar cada fuente de datos y su estatus de calidad
¿Los datos son fiables? Buscamos problemas: registros duplicados, datos atípicos, tipos de datos incorrectos (ej. fechas tratadas como texto) y, fundamentalmente, la cantidad de ruido presente.
Fase 3: Preparación de Datos (Data Preparation)
A menudo, esta fase consume el 80% del tiempo del proyecto. Tomamos los datos brutos y los transformamos en el conjunto de datos final listo para el modelo.
1. Selección y limpieza de datos
Decidimos qué columnas (características) y filas son relevantes. Eliminamos datos corruptos o innecesarios.
2. Tratamiento de datos perdidos (Nulls)
Los modelos de Machine Learning (en su mayoría) no aceptan valores nulos. Usando Python, decidimos si:
Eliminar las filas/columnas con nulos.
Imputar valores (llenar con la media, mediana, moda o usar algoritmos predictivos).
3. Tratamiento de datos outliers (Valores atípicos)
Identificamos valores extremos que pueden sesgar el modelo. Decidimos si eliminarlos, transformarlos o mantenerlos si representan anomalías reales e importantes.
4. Construcción de datos (Feature Engineering)
Aquí aplicamos la creatividad y el conocimiento del negocio. Creamos nuevas variables a partir de las existentes. Ej: Convertir una fecha en "día de la semana" o calcular la "antigüedad del cliente".
5. Integración de datos
Si tenemos múltiples fuentes, usamos pd.merge() o pd.concat() en Python para unir tablas y crear una vista única y consolidada.
6. Formato de datos
Aseguramos que todos los datos estén en el formato correcto. Esto incluye la codificación de variables categóricas (One-Hot Encoding o Label Encoding) y el escalado/normalización de variables numéricas.
Fase 4: Modelado y Evaluación (Modeling & Evaluation)
¡La parte divertida! Aquí aplicamos las matemáticas y la estadística. Aunque CRISP-DM las separa, en la práctica moderna estas fases están altamente iteradas.
1. Selección de algoritmos (mínimo 3)
No apuestes todo a una sola carta. Dependiendo de si es un problema de Regresión o Clasificación, selecciona al menos tres algoritmos diferentes para probar (ej. Regresión Logística, Random Forest, Gradient Boosting).
2. Selección de variables más importantes
Usamos técnicas para identificar qué características (features) aportan más poder predictivo y eliminamos las redundantes para simplificar el modelo y evitar el sobreajuste (overfitting).
3. Partición de muestras
Es crucial separar los datos. Usamos train_test_split de Scikit-learn para dividir los datos en:
Entrenamiento (Train): Para enseñar al modelo.
Prueba (Test): Para evaluar su desempeño con datos que nunca ha visto.
Back Testing: Para ver su desempeño en el tiempo
4. Entrenamiento del modelo
Ajustamos los algoritmos seleccionados a los datos de entrenamiento.
5. Afinamiento del modelo (Hyperparameter Tuning)
Usamos técnicas como GridSearchCV o RandomizedSearchCV en Python para encontrar la combinación óptima de parámetros de los algoritmos y maximizar su precisión.
6. Evaluación (Métricas Técnicas vs. Negocio)
Evaluamos el modelo con los datos de prueba usando métricas técnicas (Precisión, Recall, F1-Score, RMSE). Sin embargo, la pregunta final debe ser: ¿Resuelve este modelo el objetivo empresarial definido en la Fase 1? Si la respuesta es no, debemos iterar.
Fase 5: Implementación (Deployment)
Un modelo atrapado en un Jupyter Notebook no genera valor. Esta fase lleva el modelo al mundo real. Implementar el modelo para su uso.
1. Plan de implementación
Define cómo se usará el modelo. ¿Será un proceso batch (lotes) que corre cada noche? ¿O una API en tiempo real que responde a peticiones de usuarios?
2. Monitoreo y mantenimiento del modelo
El mundo cambia y los datos también (Data Drift). Debemos establecer alertas para saber cuándo el rendimiento del modelo degrada y necesita ser reentrenado con datos nuevos.
3. Publicar modelo
El paso final es poner el modelo en producción. Esto puede implicar contenerizarlo con Docker, subirlo a servicios en la nube (AWS SageMaker, Azure ML) o crear una API web sencilla con frameworks de Python como Flask o FastAPI.
Conclusión
Seguir la metodología CRISP-DM no garantiza el éxito, pero sí garantiza un proceso profesional, ordenado y orientado a resultados. Al combinar este mapa de ruta con la potencia de Python, dejas de ser un simple "tirador de código" para convertirte en un solucionador de problemas estratégicos basados en datos.
¿Estás listo para aplicar este enfoque en tu próximo proyecto?